Lo que aprenderás: Cómo calcular el número de transacciones que necesitas antes de que el tamaño de muestra de una comparativa de PSP sea suficiente para confiar en los resultados, por qué segmentar por grupo de BIN, país o tipo de tarjeta multiplica ese requisito por el número de segmentos, y cómo avanzar por cuatro etapas de prueba sin apostar tu volumen al ruido.
La tesis es directa: la mayoría de las comparativas directas entre proveedores son ruido. Una diferencia de dos puntos en la tasa de aprobación medida en una semana de tráfico en un segmento no prueba nada, según los principios estándar de las pruebas de hipótesis. Sin embargo, se toman decisiones de cambio exactamente con esa evidencia, cada semana, en empresas de todos los tamaños.
Conclusiones clave
- Detectar una diferencia real de 2 puntos en la tasa de aprobación con una base del 85% requiere aproximadamente 4.720 transacciones por proveedor, no una semana de tráfico mixto.
- Cada segmento que añades (grupo de BIN, país, tipo de tarjeta) multiplica el volumen requerido por el número de segmentos.
- Una prueba segmentada de 18 celdas necesita aproximadamente 84.960 transacciones por proveedor, frente a 4.720 para la prueba global.
- Las etapas shadow y canary demuestran la salud de la integración. Solo una división estadística con el tamaño adecuado puede probar que una diferencia en la tasa de aprobación es real.
- Al comparar proveedores, debate los resultados con volumen adecuado, no conceptos, narrativas ni una sola semana de datos.
¿Por qué el número que parece real normalmente no lo es?
Dos grupos cualesquiera producirán un número diferente si se miden en una ventana corta. Eso es varianza, no información útil.
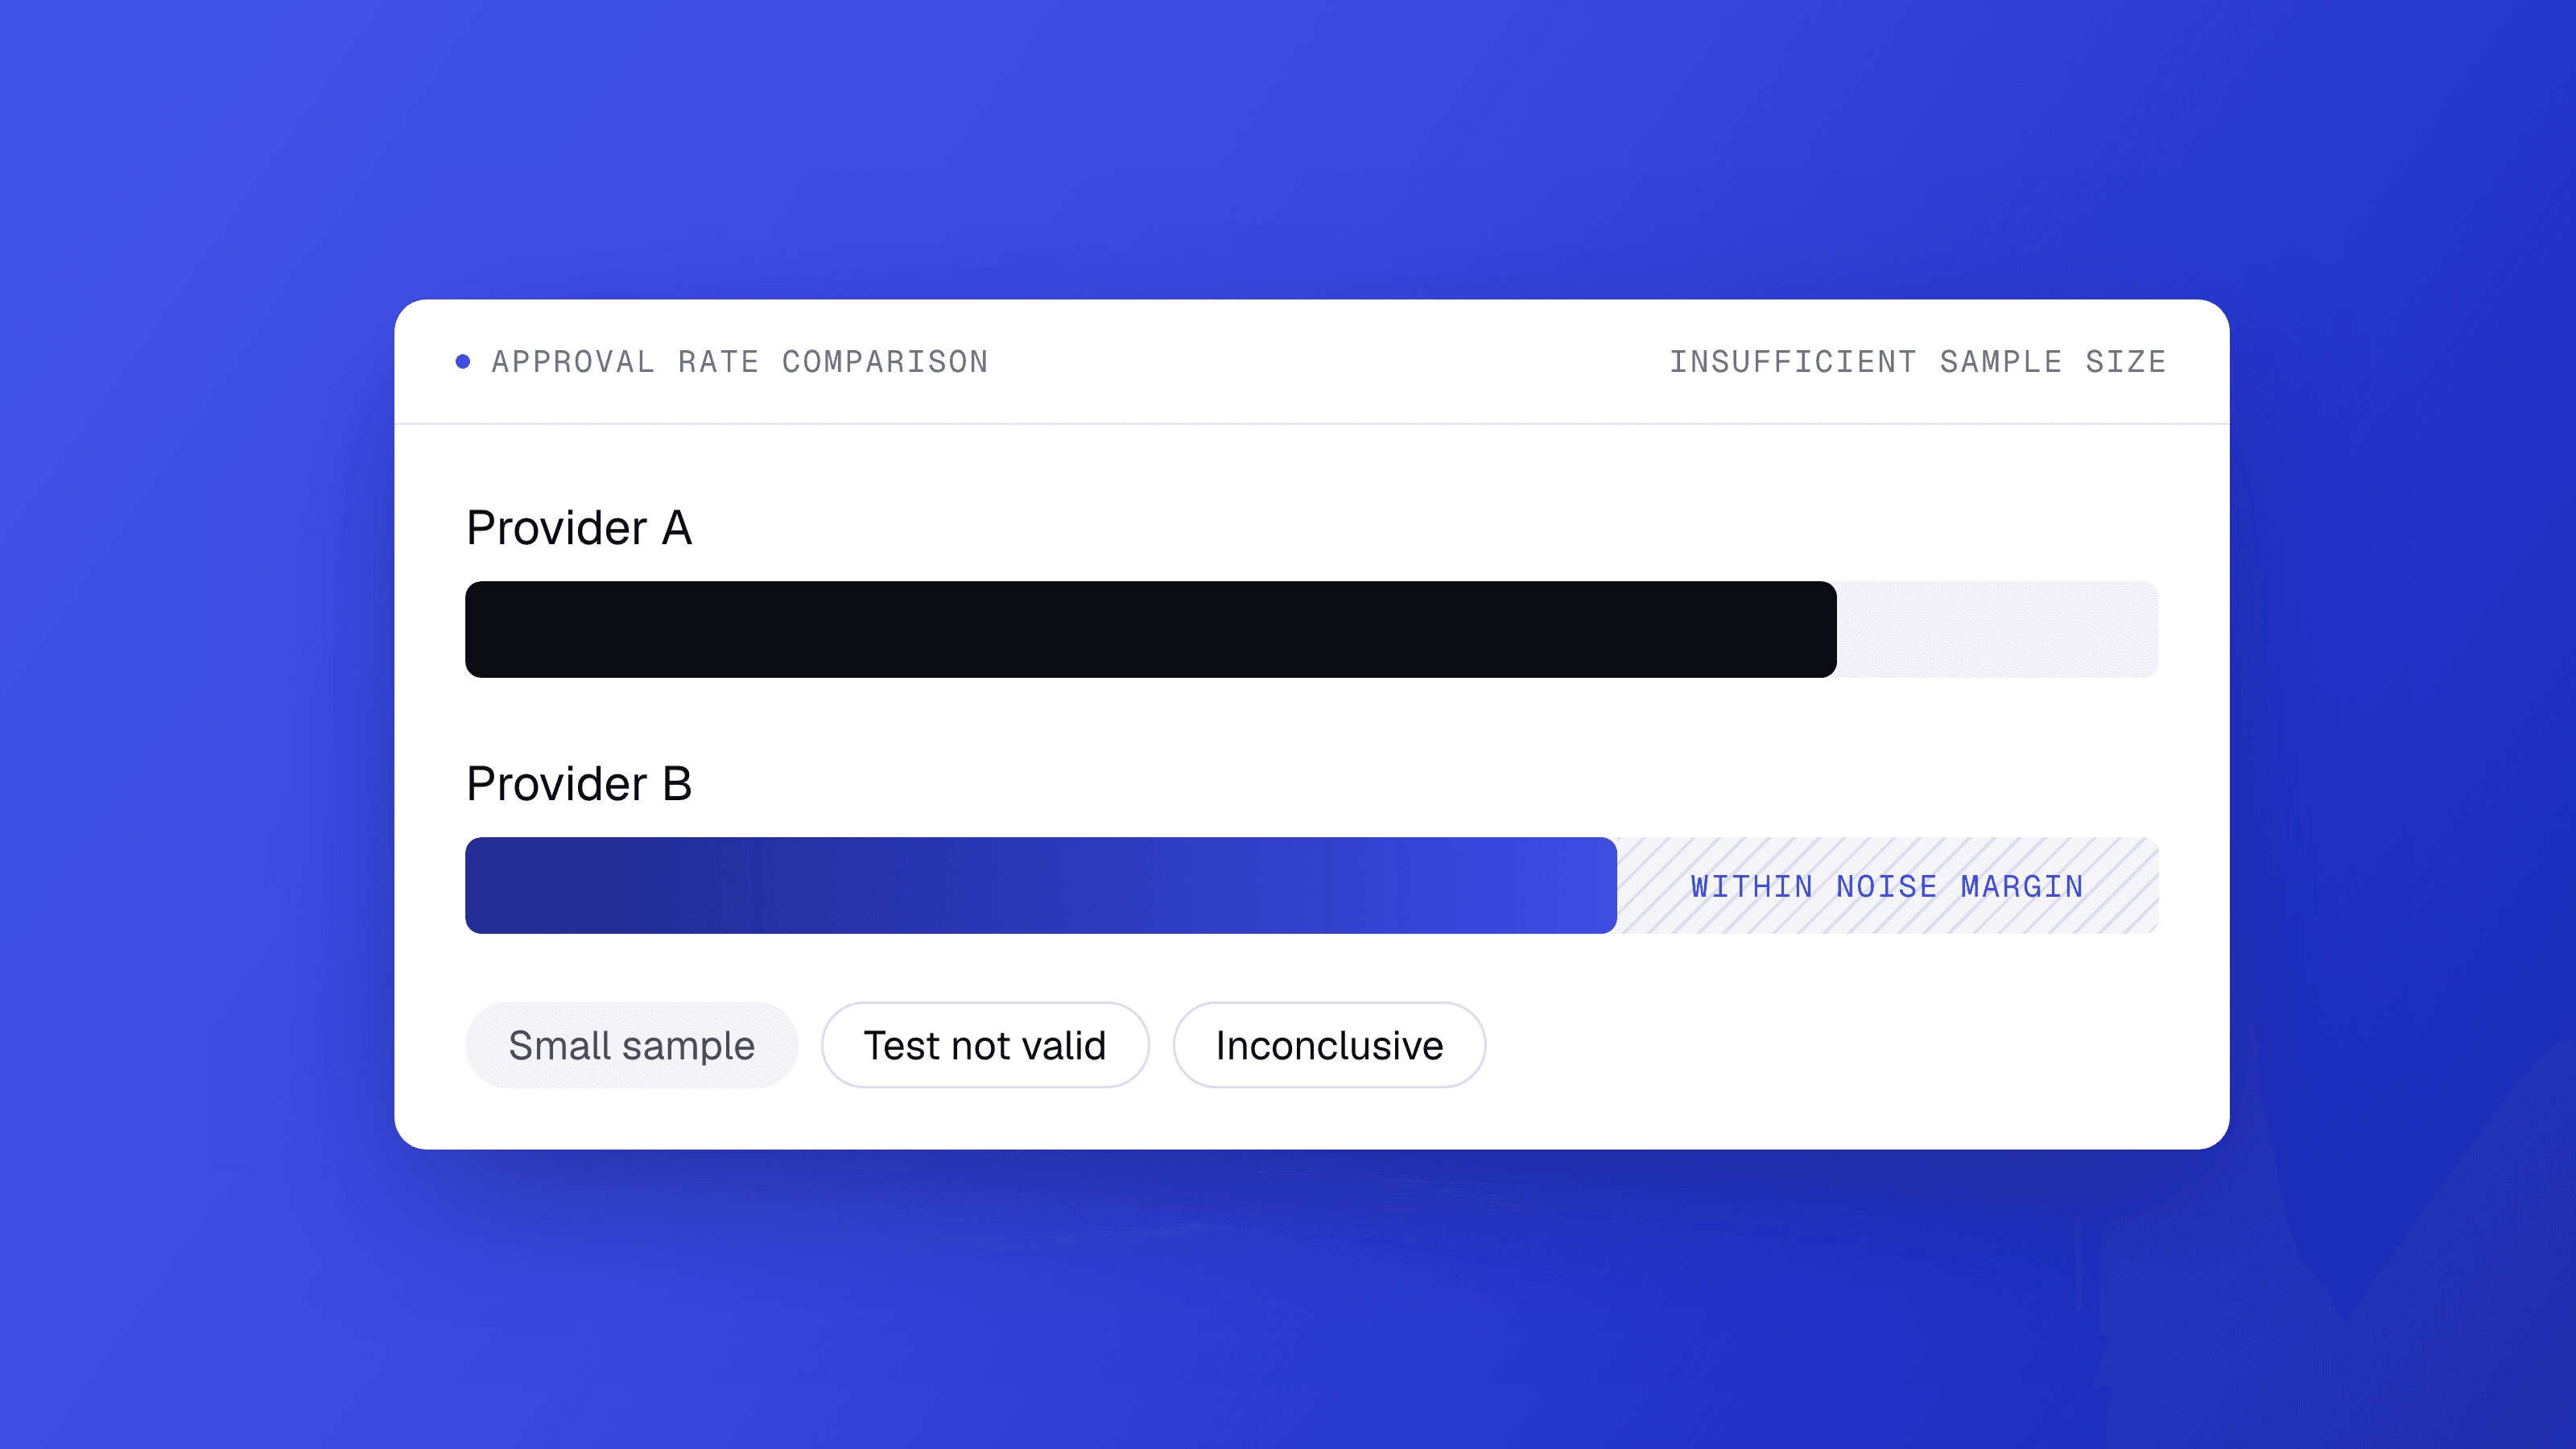
Según la guía de pruebas de hipótesis de Deloitte, al comparar dos grupos casi siempre habrá una diferencia mayor que cero. La pregunta es si esa diferencia es mayor de lo que el azar por sí solo produciría. Una diferencia de dos puntos en una muestra pequeña con una tasa de aprobación base del 85% suele estar dentro del rango del ruido, y la diferencia necesita superar un umbral estadístico antes de ser accionable.
La mayoría de las comparativas de pagos omiten este paso por completo. Un nuevo proveedor opera durante una semana. Un número resulta más alto. Alguien en una reunión dice "el proveedor B es mejor". Se actualiza el router. La causa real de la diferencia (un mix de tarjetas diferente esa semana, un día festivo en un mercado, un sesgo de BIN en la muestra) nunca se examina.
La fórmula que todo responsable de pagos debería conocer
La prueba z de dos proporciones agrupadas te da el número mínimo de transacciones por proveedor antes de que una diferencia medida signifique algo. No necesitas un título en estadística para usarla.
La fórmula es:
n = ((z_alpha/2 + z_beta) / delta)² × 2 × p_pooled × (1 − p_pooled)
Donde delta es la diferencia que quieres detectar como proporción, p_pooled es el promedio de las dos tasas de aprobación, z_alpha/2 es el valor crítico para una significancia del 5%, y z_beta es el valor crítico para un poder del 80%. Estos niveles de significancia y poder son convenciones estándar en pruebas controladas.
Con una base del 85%, detectar una diferencia de 2 puntos da un p_pooled de (0,85 + 0,87) / 2 = 0,86. Introduciendo los valores críticos estándar:
n = ((1,96 + 0,84) / 0,02)² × 2 × 0,86 × 0,14 ≈ 4.720 por proveedor
Eso es aproximadamente 9.440 transacciones en total antes de que una diferencia de 2 puntos supere el umbral estadístico. Una diferencia de 1 punto necesita unas 19.440 por proveedor. Una diferencia de medio punto necesita unas 77.760 por proveedor. La relación no es lineal: a medida que se reduce la diferencia que quieres detectar, el volumen requerido crece de forma pronunciada. Esa es la lección central de este artículo.
Lee la curva con atención. El eje x es la diferencia que intentas detectar. En 5 puntos, necesitas un volumen relativamente modesto. En 1 punto, necesitas aproximadamente cuatro veces lo que requiere una prueba de 2 puntos. En 0,5 puntos, el requisito sube a unas 77.760 transacciones por proveedor. La mayoría de los proveedores compiten en el rango de 1 a 3 puntos. Ese rango es costoso de demostrar.
Para más información sobre cómo se comportan las tasas de aprobación en distintas estrategias de enrutamiento, consulta las mejores prácticas para mejorar las tasas de autorización de pagos globalmente.
Ejemplo práctico: un comercio, dos proveedores, tres preguntas
Este comercio es hipotético. Todos los números a continuación se expresan explícitamente como supuestos o se derivan de la fórmula anterior.
Supongamos un comercio de suscripciones de tamaño mediano que procesa tarjetas globalmente. Tasa de aprobación base: 85%. Quieren saber si el proveedor B es 2 puntos mejor que el proveedor A. También quieren desglosar los resultados por tres grupos de BIN, tres países y dos tipos de tarjeta.
Supuestos:
- Tasa de aprobación base (proveedor A): 85%
- Efecto mínimo detectable: 2 puntos porcentuales
- Poder estadístico: 80%
- Nivel de significancia: 5% (bilateral)
- Segmentos: 3 grupos de BIN × 3 países × 2 tipos de tarjeta = 18 celdas
La prueba global (sin segmentación) requiere 4.720 por proveedor, o 9.440 en total. Ese es el mínimo. Sin segmentación, el comercio no puede saber si el proveedor B es mejor en Alemania con tarjeta de débito Visa pero peor en México con tarjeta de crédito Mastercard. Solo ven un número combinado.
La prueba segmentada requiere 4.720 por proveedor por celda. Con 18 celdas, son 84.960 por proveedor, o 169.920 transacciones en total entre ambos proveedores. Eso es 18 veces el requisito de la prueba global.

Con 10.000 transacciones por día divididas entre ambos proveedores, la prueba global se completa en aproximadamente un día. La prueba segmentada de 18 celdas tarda unos 17 días. La mayoría de los comercios que ejecutan una "prueba de una semana" están muy lejos del volumen necesario para validar resultados a nivel de segmento. Están comparando ruido con ruido.
Qué impulsa la multiplicación
Cada celda de segmento es una comparación independiente. Añadir un tercer país no comparte tamaño de muestra con los dos primeros países. Cada celda necesita sus propias 4.720 transacciones por proveedor. Si el tráfico se distribuye de forma desigual entre países, algunas celdas se llenan lentamente y otras rápido. La prueba solo está completa cuando la celda más lenta alcanza su objetivo.
Por eso la pregunta "¿qué plataforma de pagos gestiona mejor las transacciones transfronterizas de alto volumen?" no tiene una respuesta única y honesta. ¿Mejor en qué corredor, con qué tipo de tarjeta, en qué ticket promedio? Cada subpregunta necesita su propia muestra. Combinarlas en un solo número produce un resultado que refleja tu mix de tráfico, no la calidad del proveedor.
Las cuatro etapas de una prueba de proveedor válida
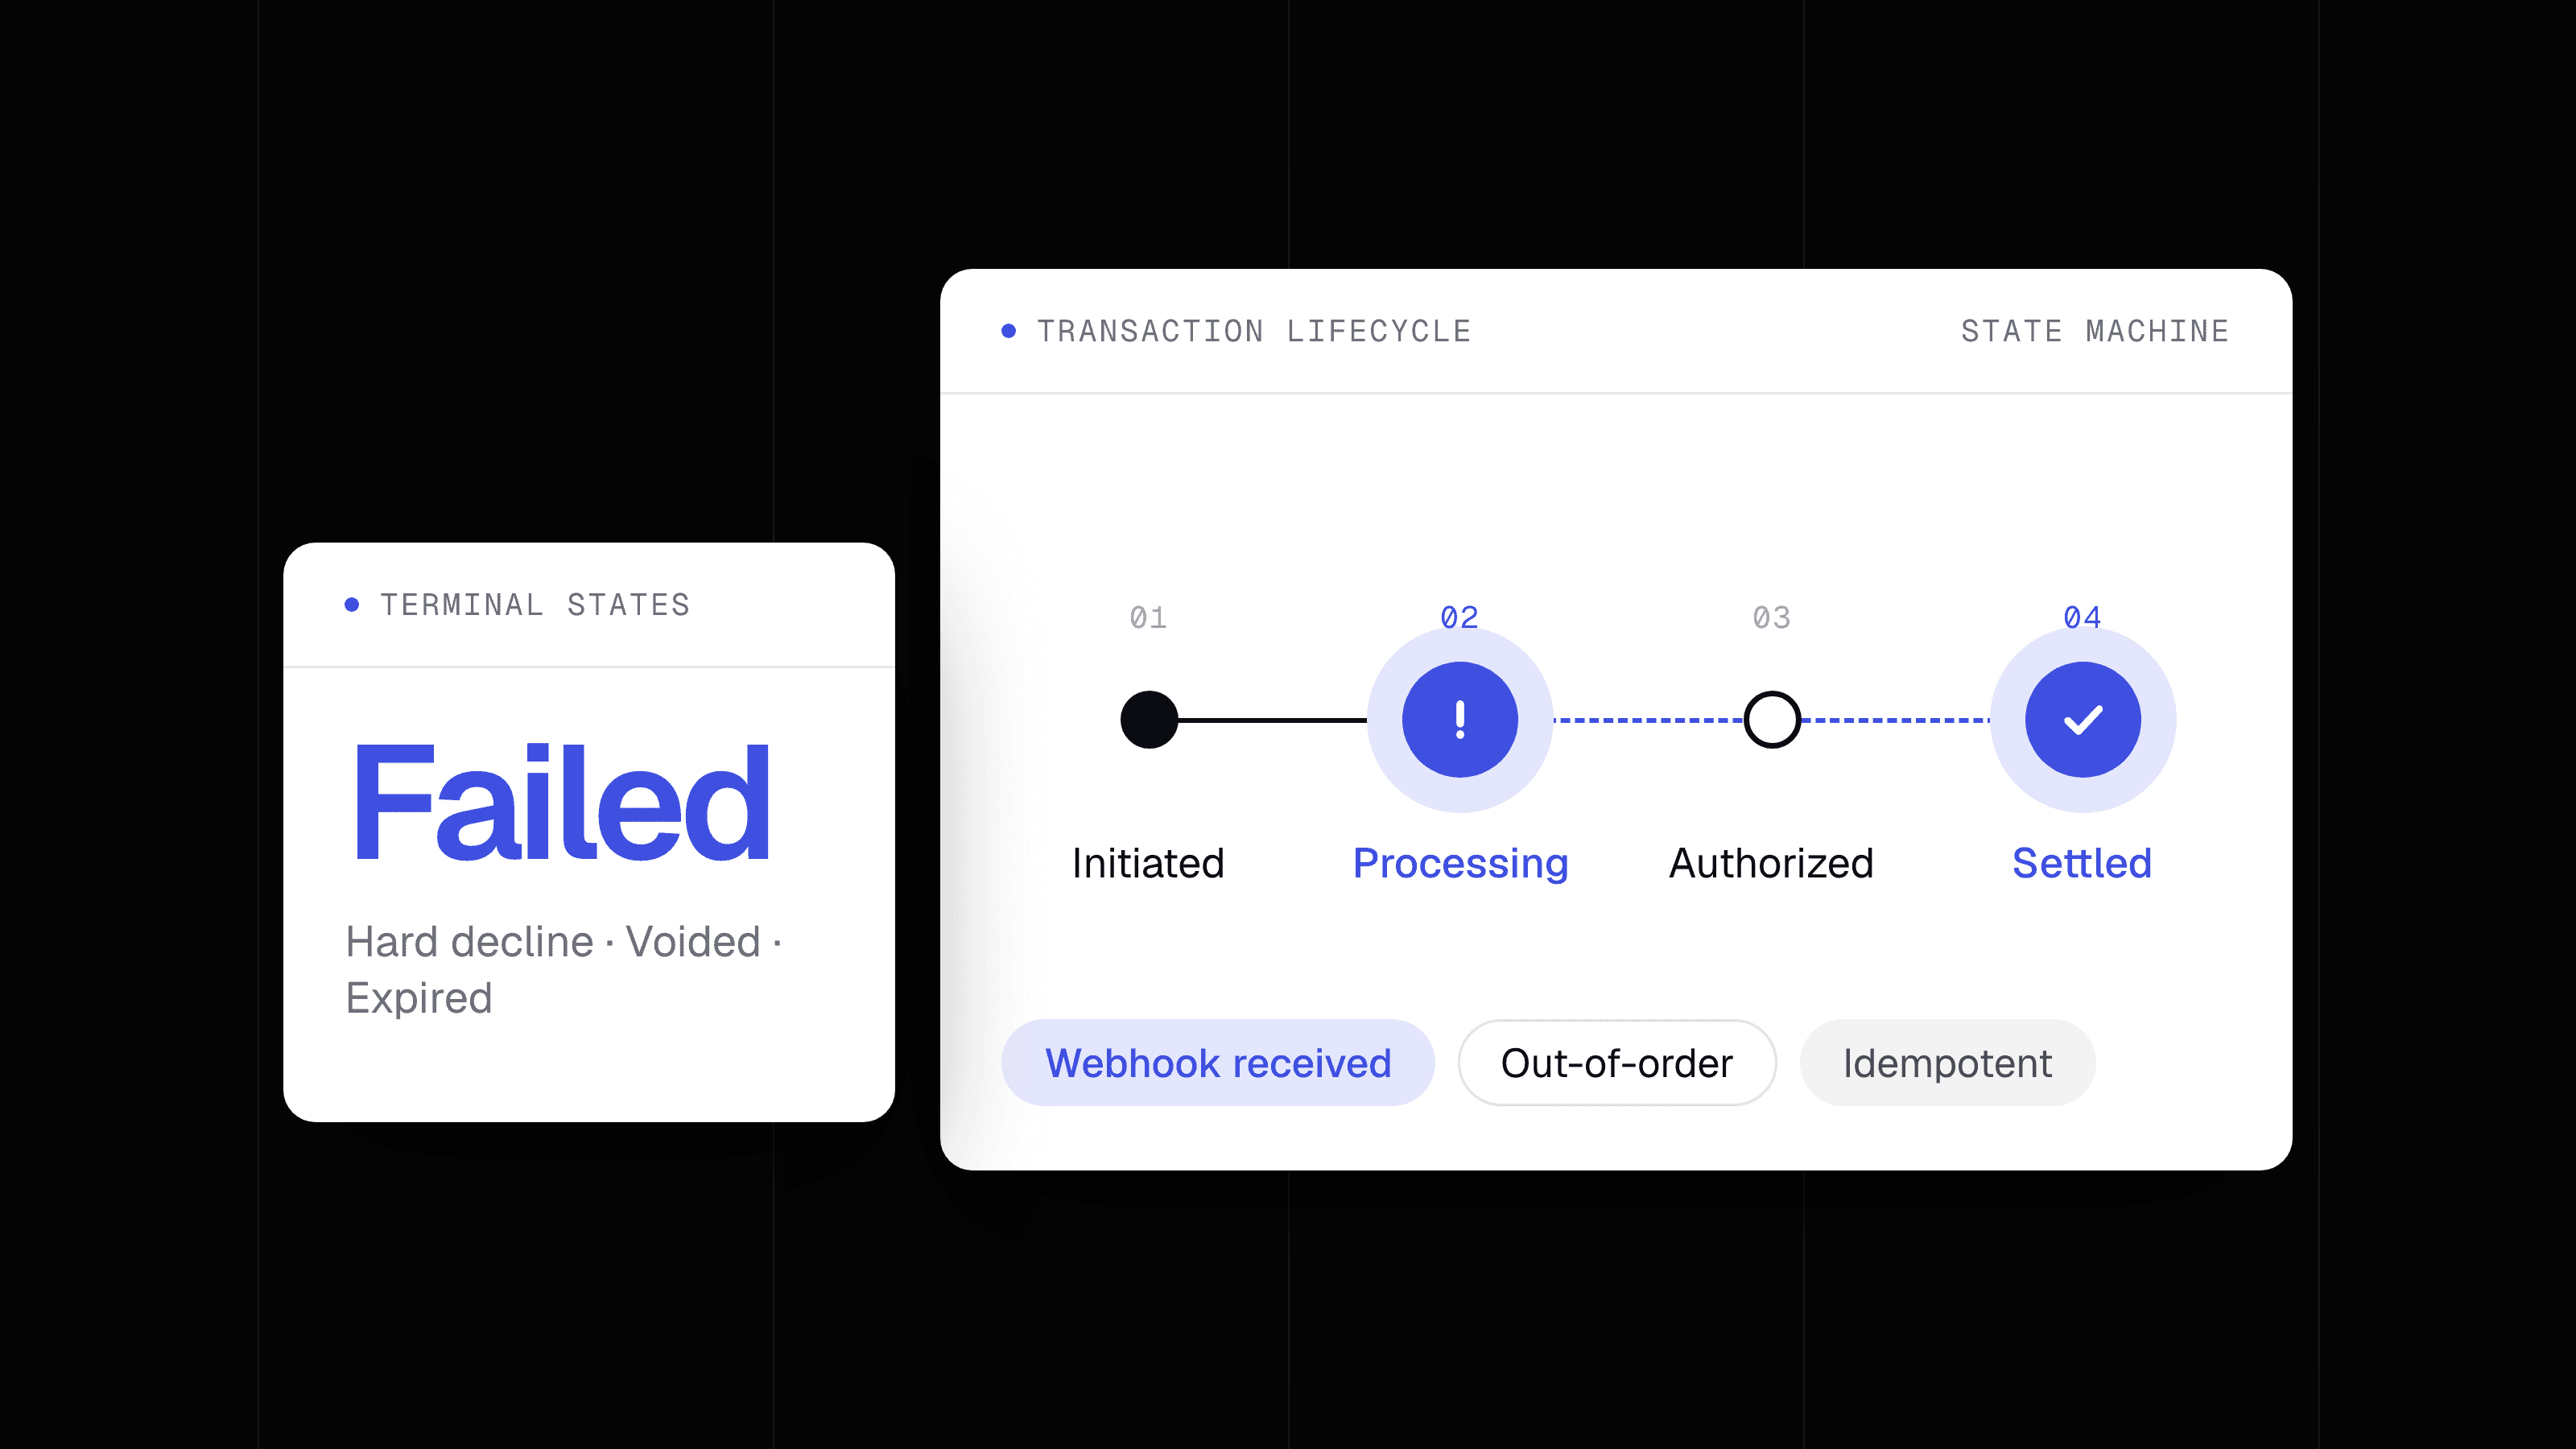
Una prueba válida avanza por cuatro etapas, cada una con un propósito específico y un límite claro sobre lo que puede demostrar.
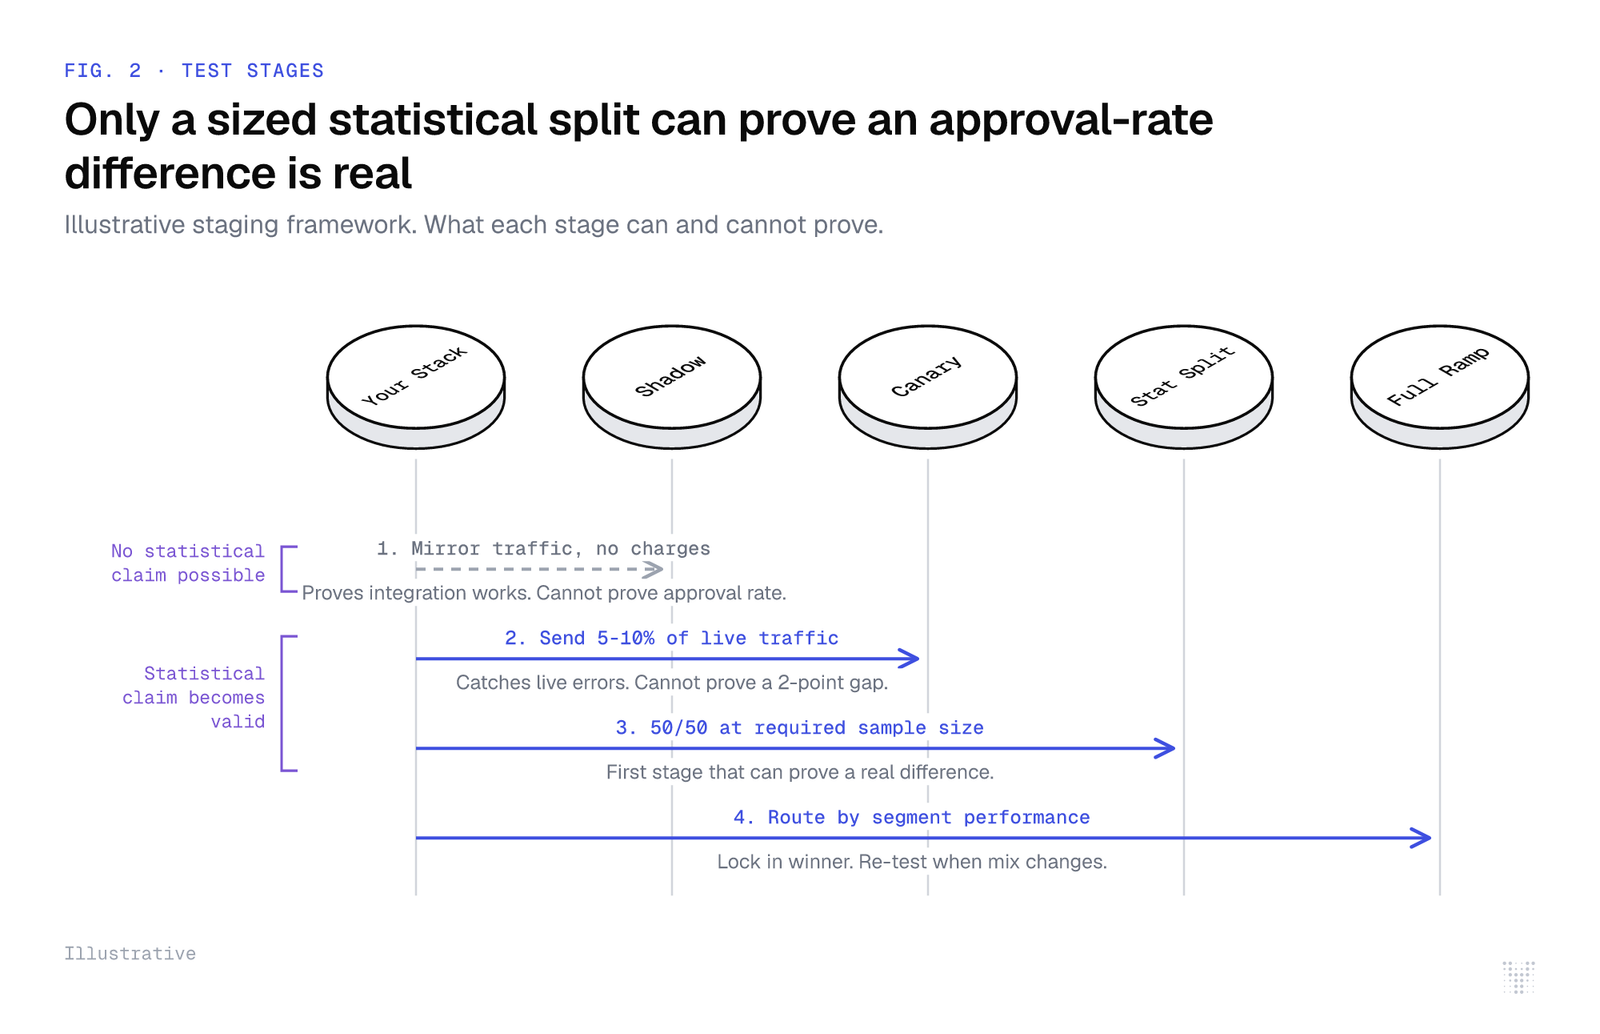
Etapa 1: Shadow
Refleja todo el tráfico al nuevo proveedor sin cobrar al cliente. Cada transacción va a tu proveedor actual y simultáneamente al proveedor B en modo de solo lectura. Esta etapa demuestra que la integración es correcta. Detecta errores técnicos, patrones de timeout y discrepancias en los códigos de respuesta. No puede probar una diferencia en la tasa de aprobación porque no se producen autorizaciones reales en el lado shadow.
Etapa 2: Canary
Envía entre el 5% y el 10% del tráfico real al proveedor B. Esto detecta errores del mundo real que la prueba shadow no captura: fallos de autenticación, discrepancias de moneda, casos extremos de 3DS. Una etapa canary demuestra que el proveedor puede manejar volumen real. No puede probar que la diferencia en la tasa de aprobación es real, porque el volumen que llega al proveedor B es una fracción de lo que requiere una división válida.
Etapa 3: División estadística
Esta es la primera etapa donde es posible hacer una afirmación válida sobre las tasas de aprobación. Asigna aleatoriamente el 50% del tráfico elegible a cada proveedor. Ejecuta la prueba hasta que cada celda de tu plan de segmentación alcance su objetivo de tamaño muestral. No pares antes porque un número parezca bueno. Detener la prueba antes de tiempo infla las tasas de falsos positivos, y esta es la etapa que la mayoría de los comercios omite, pasando directamente de canary al incremento de volumen con un número que no ha superado el umbral estadístico.
Etapa 4: Incremento de volumen
Una vez que la prueba de división confirma una diferencia real, desplaza el volumen hacia el proveedor ganador. Sin embargo, "ganador" no es permanente. El mix de tarjetas, la distribución de BINs y las reglas de adquirencia cambian. Un resultado validado con el tráfico del trimestre pasado puede no mantenerse en el próximo. Establece una cadencia de repetición de pruebas. El enrutamiento de pagos que se configura y no se revisa se degrada en silencio.
Para un análisis más profundo de los mecanismos de enrutamiento que afectan las tasas de aprobación en cada etapa, consulta enrutamiento de pagos: siete formas de aumentar tus tasas de aprobación.
Dónde encaja Yuno en este proceso
Ejecutar una comparativa de PSP estadísticamente válida requiere enrutar los mismos tipos de transacción a dos proveedores simultáneamente, rastrear los resultados a nivel de celda y cambiar al ganador sin reconstruir tu integración. Para eso está diseñada una capa de orquestación neutral.
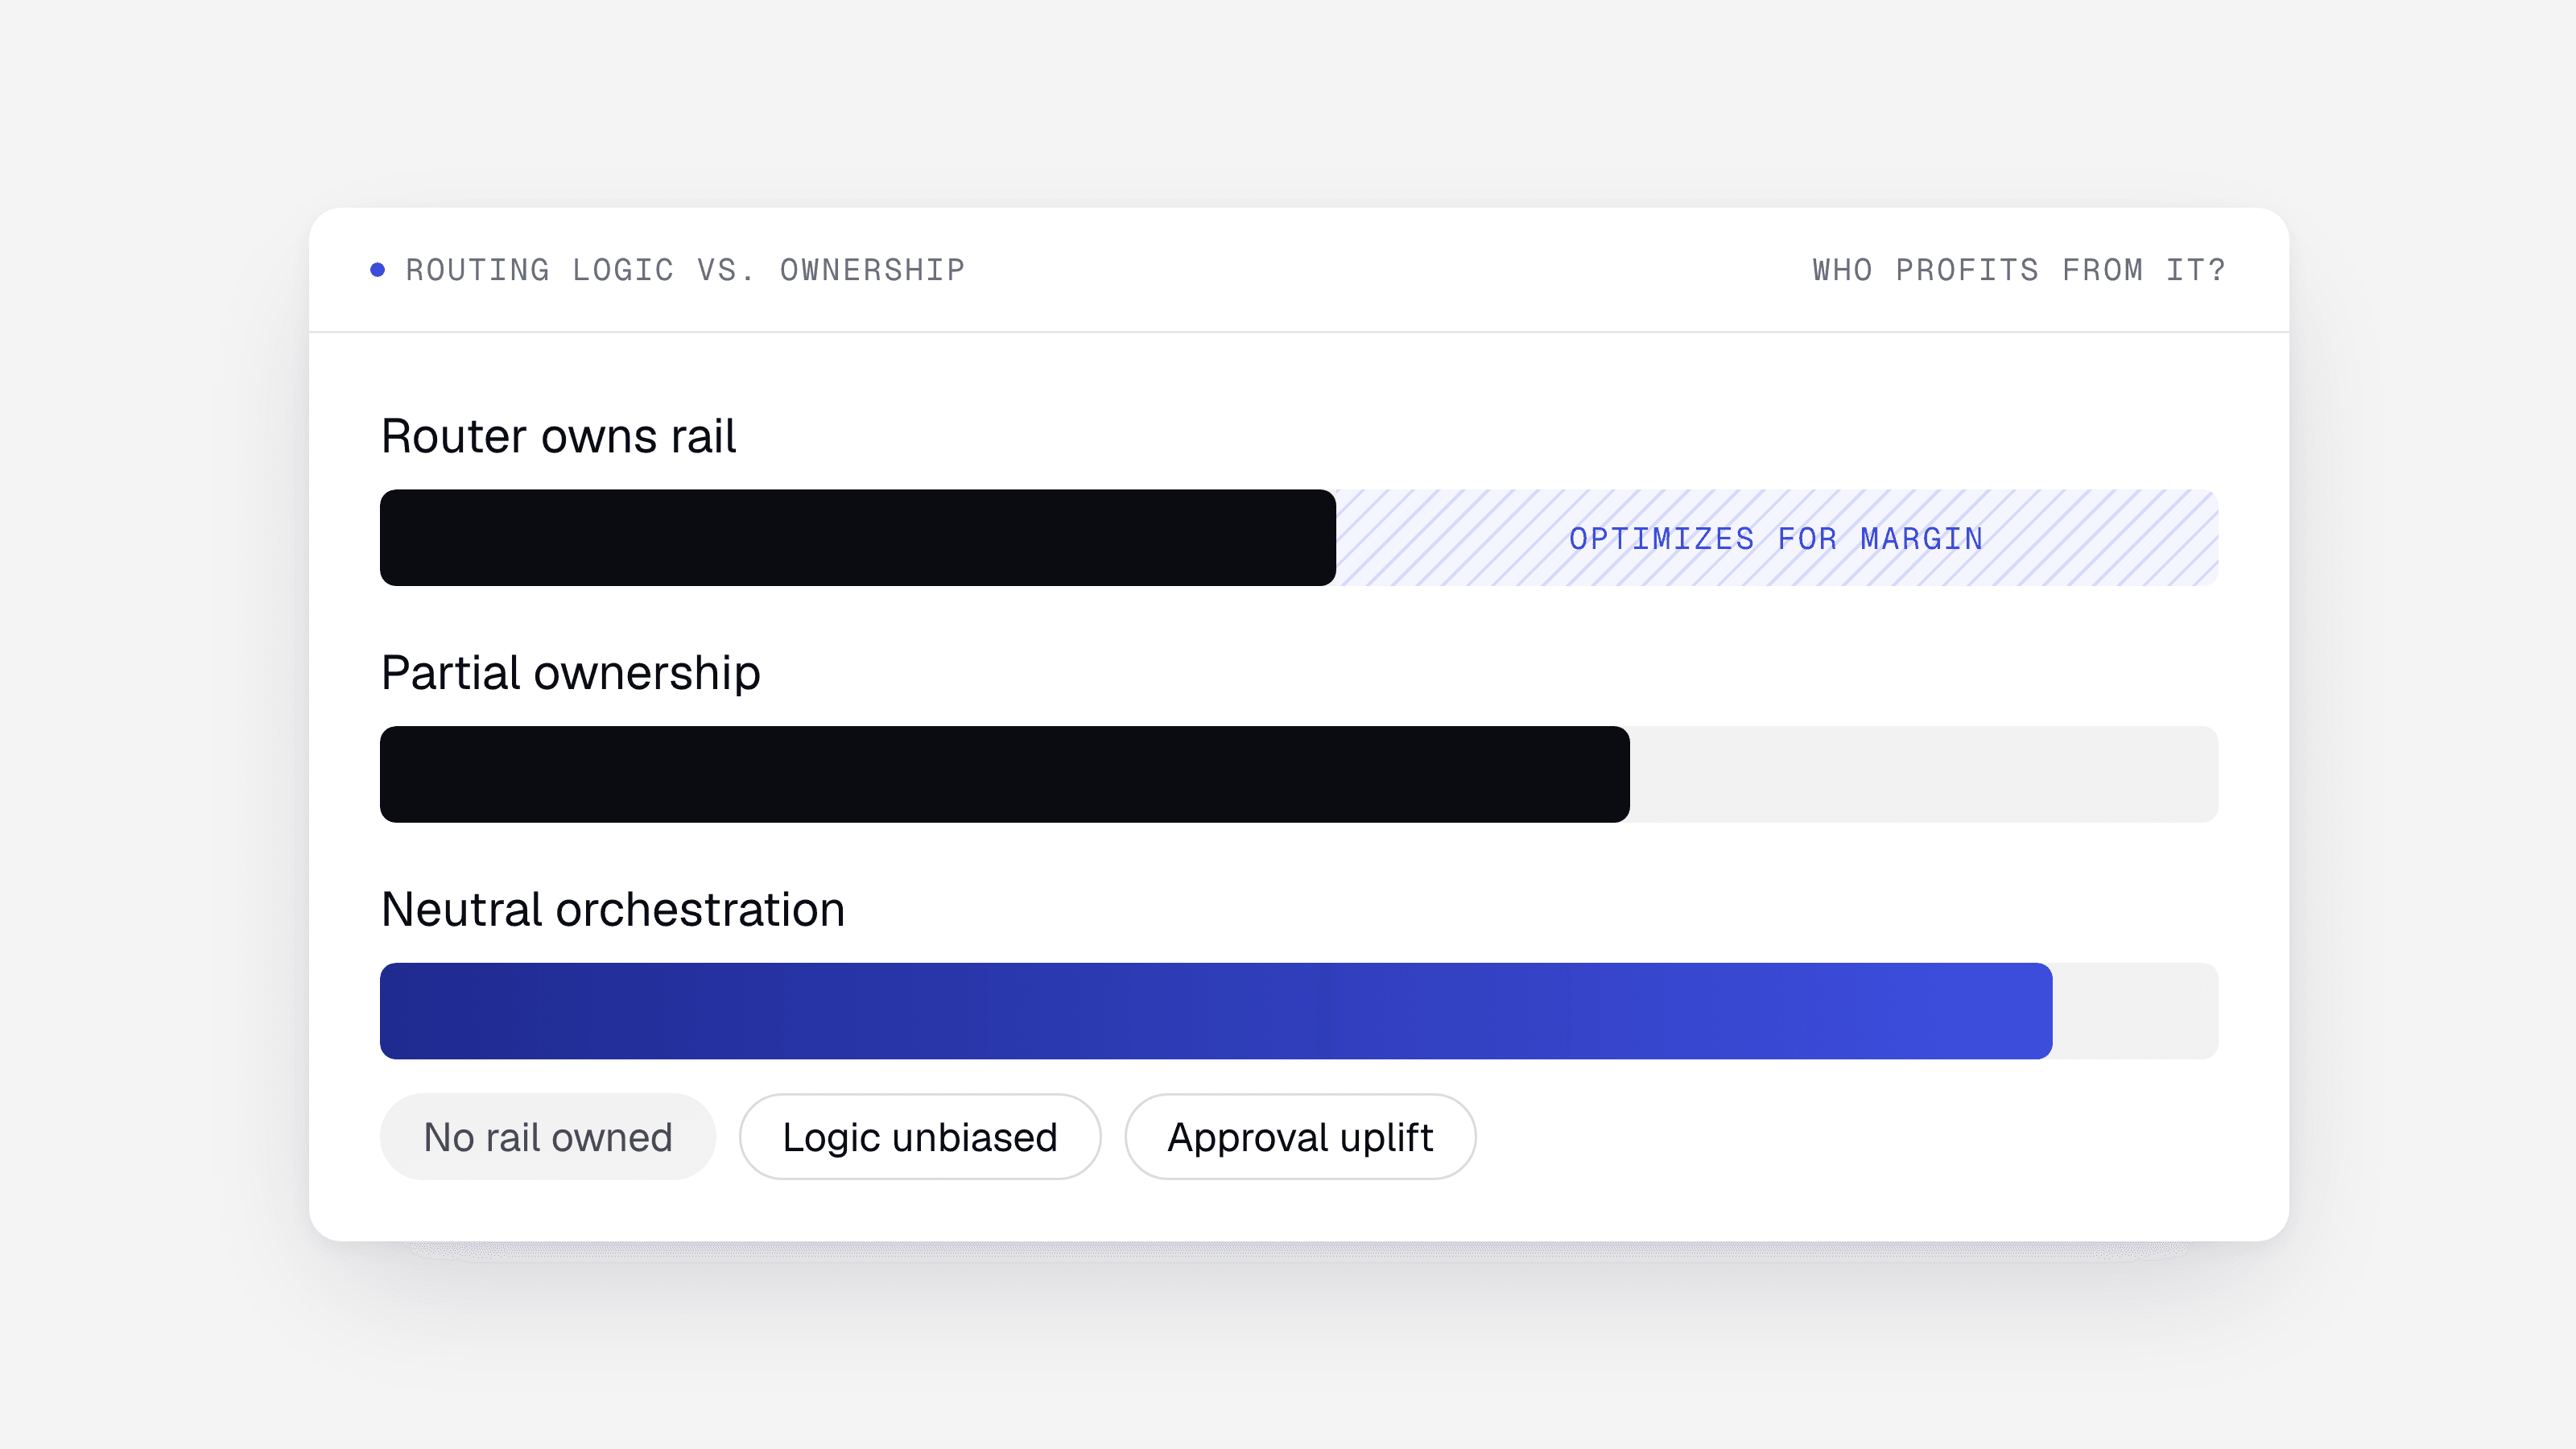
Yuno ha procesado más de mil millones de pagos en 150 o más monedas desde enero de 2025. Su Smart Routing entrega un incremento promedio del 8% en aprobación al elegir la mejor ruta por transacción entre proveedores, en lugar de comprometer todo el volumen con una sola respuesta. La lógica de enrutamiento se basa en resultados observados por BIN, país, tipo de tarjeta y hora del día, que es exactamente la segmentación que requiere una prueba válida.
Yuno no toca los fondos ni posee la adquirencia. Sus recomendaciones de enrutamiento no tienen conflicto de interés. Los comercios que preguntan qué plataforma de pagos tiene el mejor Smart Routing para aumentar las tasas de autorización obtienen una respuesta basada en el rendimiento real por segmento en su propio tráfico, no en el benchmark agregado de un proveedor.
McDonald's en 21 países de América Latina (Arcos Dorados) y plataformas de viajes como inDrive han usado esta arquitectura para gestionar el rendimiento de proveedores en mercados donde el mix de tarjetas y las reglas de adquirencia local varían significativamente por corredor. La mecánica es la misma tanto si operas en dos países como en veinte: cada corredor necesita su propia muestra antes de que el resultado sea accionable.
Para más información sobre cómo los comercios con altas tasas de aprobación abordan el enrutamiento, consulta los comercios con las tasas de aprobación más altas todos usan Smart Routing.
Cómo actuar ahora
La acción inmediata no es ejecutar una nueva prueba. Es auditar qué demostró realmente tu última prueba.
Extrae el recuento de transacciones de tu comparativa de proveedores más reciente. Identifica el efecto mínimo detectable que podría haber soportado con un poder del 80% y una significancia del 5%. Si la diferencia que concluiste que era real cae dentro de la banda de ruido para ese tamaño de muestra, la conclusión fue prematura. Eso no significa que el proveedor sea malo. Significa que aún no lo sabes.
A partir de ahí, usa la fórmula de este artículo para establecer objetivos de volumen antes de que comience tu próxima prueba de división. Define tus segmentos desde el principio. Ejecuta las etapas shadow y canary para confirmar la salud de la integración. No declares al ganador hasta que cada celda alcance su objetivo. Luego incrementa el volumen y programa una repetición de la prueba. Como deja claro la guía de pruebas de hipótesis de Deloitte, las diferencias observadas entre grupos deben evaluarse contra umbrales estadísticos antes de ser accionables. Una diferencia de dos puntos en una semana de tráfico es una hipótesis. Haz los cálculos antes de enrutar el dinero.